為什麼要本地 AI?企業把 AI 搬回自己機房的 6 個理由
資料不出公司、符合法規與客戶合約、用量大時成本可預測、斷網也能運作、可以客製又能固定版本、不被單一供應商綁住。本文整理企業選擇本地 AI 的六個理由與成本算法,也誠實說明代價,以及該從哪個任務開始試。
重點摘要
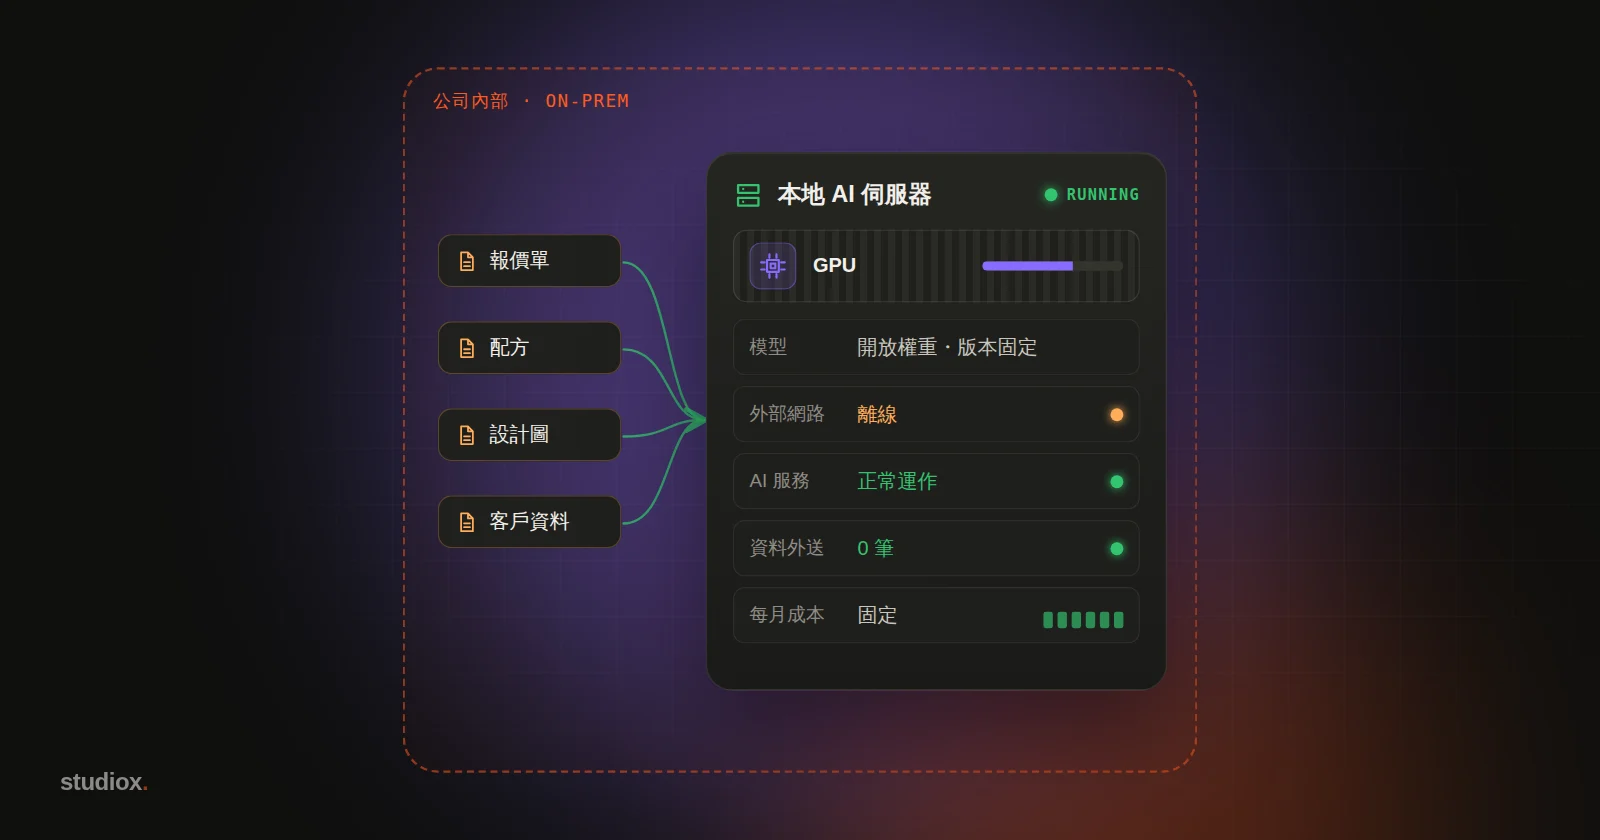
- 企業選擇本地 AI,最常見的理由是資料機密與合規:報價、配方、圖面和個資不必離開公司。
- 每天大量、穩定地處理同類工作時,本地的固定成本可能比按用量計費划算,但損益平衡點會隨雲端降價與硬體使用率移動。
- 本地也代表自己承擔硬體、電力、維運與模型更新,複雜推理仍不及最前沿的雲端模型,因此多數企業最後採用混合架構。
- 從一個敏感又大量的任務開始,在一台工作站上試點、把數字量出來,再決定要不要擴大。
文章目錄
業務把客戶的報價單貼進聊天機器人,請它整理成比較表;工程師把圖面規格丟給 AI,請它找出和上一版的差異。事情做得又快又好,直到老闆問了一句:「這些資料,現在在誰的伺服器上?」
這不是杞人憂天。2023 年,三星電子發現工程師把內部原始碼上傳到 ChatGPT 之後,限制員工在公司設備上使用生成式 AI 工具。到了 2026 年,我們越來越常被問到另一個問題:能不能把 AI 裝在公司自己的設備上跑?
我們在〈小模型與地端 AI〉比較過雲端與地端的差異,也整理了判斷流程。這篇往前退一步,回答更根本的問題:企業為什麼要本地 AI?這筆帳算得過來嗎?
本地 AI 指的是什麼?
本地 AI(也常稱為地端 AI、On-premise AI)指的是模型檔在你手上、運算發生在你控制的硬體上:可能是機房裡的 GPU 伺服器、辦公室裡的一台 AI 工作站,甚至是員工的筆電。資料送進模型、產生結果,全程不經過外部的 AI 服務商。
它和雲端 AI 最大的差別不是能力,而是控制權:資料放哪裡、用哪個版本、何時升級、每月花多少,都由你決定;責任也一起回到你身上。
六個理由:企業為什麼把 AI 搬回公司
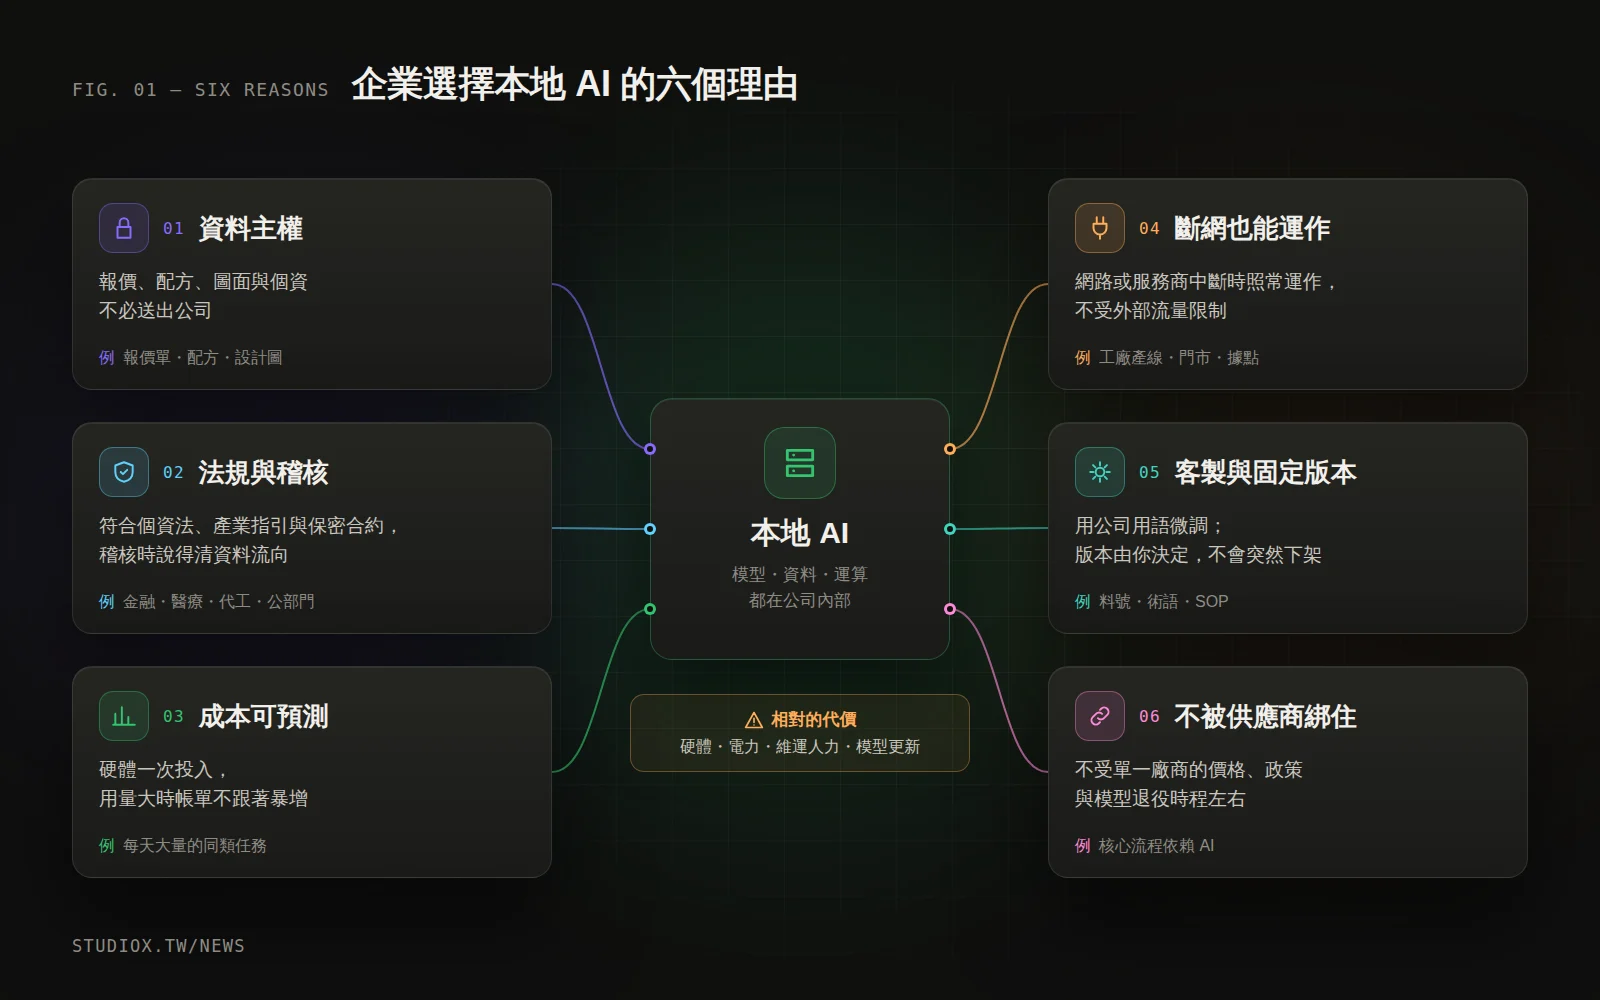
1. 資料主權:機密不必離開公司
報價與成本、配方與製程參數、設計圖、客戶名單與個資,是企業最核心的資產。主要雲端 AI 服務的企業方案其實已經提供不少保障,例如 OpenAI 表示預設不會用企業方案與 API 的資料訓練模型。但對某些資料來說,問題不是「對方可不可信」,而是**「這份資料根本不該出去」**。本地 AI 讓這個問題直接消失。
2. 法規、客戶合約與稽核
很多限制不是公司自己訂的:
- 個資:把客戶個資交給外部服務處理,要先想清楚是否屬於個資法上的「委託處理」。依個資法施行細則第 8 條,委託者必須監督受託者,包括委託結束後資料的返還與刪除。
- 金融業:金管會的金融業運用人工智慧(AI)指引提醒金融機構監督第三方 AI 業者,並建議為停止委託的情況訂定資料與系統的遷移機制。
- 公部門:行政院的生成式 AI 參考指引不允許承辦人把應保密的公務資訊或個人資料提供給生成式 AI,但封閉式地端部署的模型在確認系統環境安全後,可以依機密等級分級使用。
- 客戶合約:代工、設計等產業的保密協議常限制資料交給第三方;客戶稽核時,你得說清楚資料流向。
本地部署讓「資料去了哪裡」的答案變得很短。更完整的法規整理,請見〈AI 法規 2026〉。
3. 用量大時,成本比較好預測
雲端用得越多、帳單越高;本地是一次性的硬體加上大致固定的電力與維運。每天大量處理同一類工作時,固定成本就有機會被攤平,下一節會細算。
4. 斷網、塞車也照常運作
雲端服務也會中斷。2025 年 6 月 10 日,OpenAI 的 API、ChatGPT 與 Sora 出現長時間的錯誤率升高;同年 11 月 18 日,Cloudflare 的一次故障讓 X、ChatGPT 等服務一度無法使用。對工廠產線、門市與客服來說,本地模型在斷網時照樣能跑,速度也不受外部尖峰與流量限制影響。
5. 客製化與固定版本
本地模型可以用公司自己的資料微調,讓它熟悉產品料號、製程術語、內部簡稱與文件格式。更常被忽略的是版本由你決定。雲端模型會依供應商的時程退役:Anthropic 的模型淘汰政策寫明,公開模型退役前至少提前 60 天通知,退役後的請求就會失敗;OpenAI 也在 2026 年 2 月讓 GPT-4o 等舊模型從 ChatGPT 下架。流程若已驗證、寫進 SOP,底下的模型一換,輸出與準確度都可能跟著變。本地模型沒人會替你換掉,要升級時先測試再切換。
6. 不被單一供應商綁住
價格方案、使用政策、地區可用性、模型下架時程,都由供應商決定。前面提到金管會指引建議準備遷移機制,處理的就是這個風險。開放權重模型的檔案下載後就在你手上,在授權條款允許的範圍內可以一直使用,也能隨時換成別的模型。
| 理由 | 最有感的情境 | 導入前先確認 |
|---|---|---|
| 資料主權 | 報價、配方、圖面、客戶資料 | 資料分級:哪些真的不能出去 |
| 法規與合約 | 金融、醫療、代工、公部門 | 條文與合約的實際要求 |
| 成本可預測 | 每天大量、穩定的同類任務 | 每月處理量與成長趨勢 |
| 斷網可用 | 工廠產線、門市、偏遠據點 | 可以接受停機多久 |
| 客製與固定版本 | 專業術語多、流程需要驗證 | 有沒有足夠的範例資料 |
| 不被綁住 | 核心流程高度依賴 AI | 換模型的成本與測試方法 |
算一筆帳:什麼時候本地比較划算?
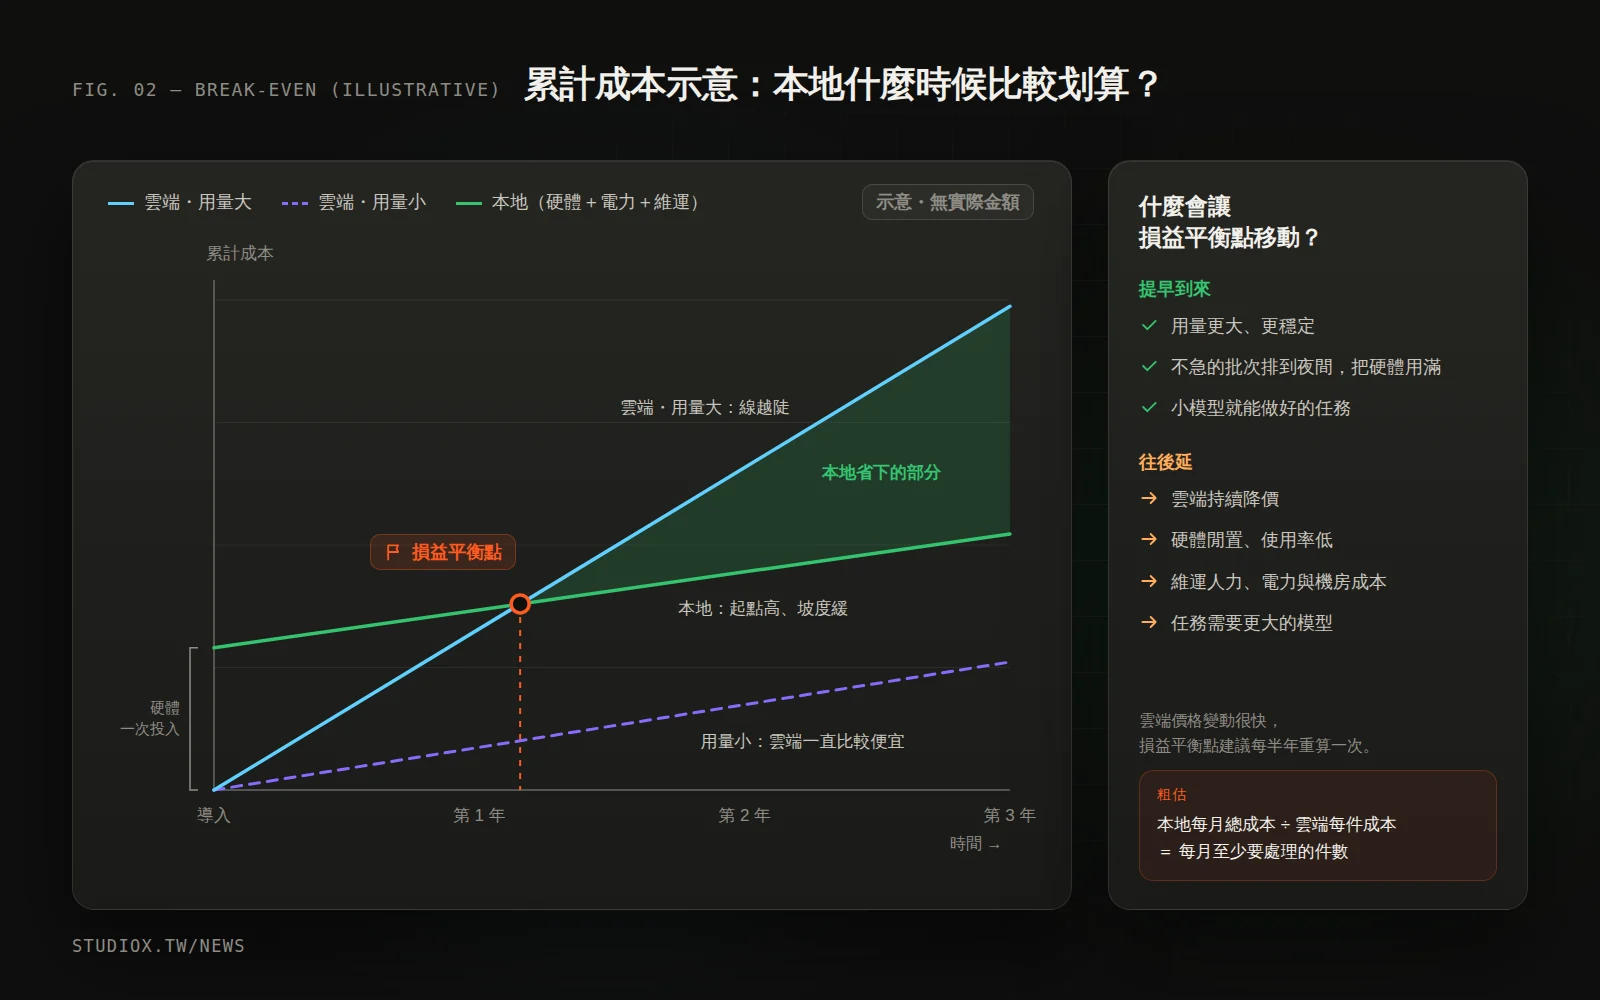
兩種成本的結構完全不同:
- 雲端:成本 ≈ 處理量 × 單價。沒有前期投入,用多少付多少;用量翻倍,帳單也翻倍。
- 本地:成本 ≈ 硬體(一次投入、分年攤提)+ 電力與散熱 + 維運人力與模型更新。在硬體容量之內,多處理一件的額外成本很低。
把累計成本畫成線,本地「起點高、坡度緩」,雲端「從零開始、坡度看用量」。用量大時,兩線會在某個時間點交叉,那就是損益平衡點;用量小時,雲端可能一直比較便宜。
粗估的方法很簡單:本地每月總成本(含硬體攤提)÷ 雲端每件成本 = 每月至少要處理多少件才划算。 算的時候,有三件事容易被忽略:
- 雲端一直在降價。 a16z 比較 2021 年以來的價格後指出,同等能力的 LLM 推論成本大約每年降到十分之一。今天算出的損益平衡點,明年可能往後移,要定期重算。
- 硬體閒著也在花錢。 本地設備要充分使用才划算;把不急的批次工作排到夜間,可以提高使用率。
- 用量會長大。 AI 變便宜、變好用之後,用量往往成長得比預期快(見〈傑文斯悖論:AI 越便宜,企業為什麼反而花得更多?〉)。這對雲端帳單是壓力,對本地則要預留擴充的空間。
為什麼是現在?四個讓本地 AI 變實際的改變
幾年前,本地 AI 意味著昂貴的伺服器與專門團隊。現在門檻明顯降低了:
- 開放權重模型變強了。 除了 Llama、Qwen、Gemma、Mistral 等模型家族,OpenAI 在 2025 年以 Apache 2.0 授權釋出 gpt-oss:gpt-oss-120b 可以放進單張 80GB GPU,gpt-oss-20b 在 16GB 記憶體內就能執行。繁體中文方面,國科會推動的 TAIDE 也以開放模型為基礎,釋出加強台灣用語的模型。
- 量化讓模型變小。 把模型權重從 16 位元壓縮到 4 位元,存放權重所需的記憶體大約只剩四分之一。代價是可能損失一些準確度,壓得越多越需要實測。
- 執行工具成熟了。 Ollama、LM Studio、llama.cpp 讓一台電腦就能跑模型;要讓多人同時使用,則有 vLLM 這類伺服器端引擎。Ollama 與 vLLM 都提供和 OpenAI API 相容的介面,程式要在雲端與本地之間切換更容易。
- 硬體走進辦公室。 NVIDIA 在 2025 年 10 月開賣桌上型的 DGX Spark,配備 128GB 統一記憶體,官方表示可在本地推論最多 2,000 億參數的模型,華碩、宏碁、技嘉、微星等台灣品牌也有同架構機種;工作站顯示卡 RTX PRO 6000 Blackwell 則有 96GB 記憶體。筆電端,微軟的 Copilot+ PC 要求 NPU 達 40 TOPS 以上。
誠實面:本地 AI 的代價與限制
本地 AI 不是免費的,也不是萬能的:
| 代價 | 實際上是什麼 | 怎麼降低 |
|---|---|---|
| 硬體 | GPU 伺服器或工作站、備援、容量規劃 | 先用一台工作站試點,再擴充 |
| 電力與空間 | 單張工作站顯示卡最高耗電可達 600W,還要散熱與不斷電 | 選對模型大小,不必追最大 |
| 維運人力 | 系統更新、監控、備份、權限與資安 | 找合作夥伴代管,或從非關鍵流程開始 |
| 能力差距 | 複雜推理、長文件、多步驟任務仍是前沿雲端模型較強 | 難的任務留給雲端 |
| 模型更新 | 新模型推出得快,要自己評估、替換 | 建一組固定測試題,換模型前先跑 |
| 授權 | 每個開放權重模型的條款都不同 | 導入前確認商業使用限制 |
最後要記得:本地不是全有或全無。 多數企業最後走的是混合架構:敏感、大量、範圍明確的任務在本地處理,需要頂尖推理能力或偶爾才用的任務交給雲端。要怎麼分,可以用〈小模型與地端 AI〉裡的三個問題判斷。
怎麼開始:一個任務、一台工作站、一組數字
不必一開始就買伺服器。建議照這四步走:
- 挑一個「敏感又大量」的任務。 資料不適合外送、每天都在做、範圍明確、對錯判斷得出來。例如從訂單與報價單擷取欄位、客服紀錄分類與個資遮蔽。
- 在一台工作站上試點。 用開放權重模型加上本地執行工具,拿過去的真實資料測試兩到四週;同一批題目去識別化後,也交給雲端模型跑一次當作對照組。
- 把數字量出來。 準確率、每件處理時間、多人同時使用的速度,以及含硬體攤提、電費與人力的每件成本;也記下它錯在哪裡。
- 再做決定。 本地表現夠好、用量又大,就規劃正式的伺服器;本地只能做好一部分,就走混合架構;雲端明顯更划算,就先留在雲端,半年後再算一次。
還在猶豫第一個流程選哪個,可以先看〈傳產導入 AI 先別急著買工具〉。
本地 AI 的價值,不在於「自己架很厲害」,而是讓你對資料、成本與版本重新握有主導權。如果你想評估哪些流程適合放在本地、硬體怎麼配、怎麼和現有系統整合,歡迎參考我們的 AI 導入與整合服務與企業系統開發服務,或直接和我們聊聊你的需求。