Jev 是什麼?重複的判斷能交給 AI 嗎?怎麼先驗證
Jev 是 TypeSafe AI 在 2026 年 9 月推出的決策模型,直接回傳選項與信心值。想把每天的小判斷交給 AI,現在就能先請 AI 助理整理規則、試判舊案子;本文也說明 Jev 和 LLM 怎麼分工,以及怎麼用自己的資料驗證。
重點摘要
- 先直接問 AI:請 ChatGPT、Claude 或 Gemini 把資深同事的判斷整理成規則表,再用上個月的案子試判;同時在試算表記錄每一次的判斷與最後結果,之後驗證任何模型都用得到。
- Jev 不產生文字,而是針對你事先定義的問題,直接回傳選項、分數或是非機率,並附上信心值,程式可以直接接著用。
- 信心值要經過校準才能設門檻:有把握的自動處理,沒把握的轉給人,門檻依出錯的影響決定。
- Jev 剛上市、仍在早期存取,速度與成本數字來自原廠;先用自己的歷史決策做影子測試,再決定要不要上線。
文章目錄
Jev 是美國新創 TypeSafe AI 在 2026 年 9 月 15 日發表的決策模型,專為判斷而設計:不寫文字,直接回傳決策與信心值。有把握的案子可以交給系統,沒把握的轉給人;不過它剛推出,要不要用,最好先用自己的歷史決策驗證。
每天早上,業務助理打開信箱,就開始一連串小判斷:這張訂單可以直接建單,還是要先問業務?這位客戶的付款條件要不要再審一次?這則 LINE 訊息是詢價、催貨,還是客訴?這些判斷大多靠資深同事的經驗,而且判斷得很準。量一多,自然會想:能不能讓清楚的案子自動處理,把人的時間留給真正需要判斷的? 這篇先給現在就能用的問法和準備,再說明 Jev 是什麼、怎麼驗證。
先直接問 AI
不管之後用不用 Jev,現在就能請 ChatGPT、Claude 或 Gemini 這類 AI 助理,幫你把判斷整理清楚、先試一次。把內容換成你自己的就好(範例都是示意)。
把資深同事的判斷整理成規則表
我們的業務助理每天要判斷客戶訂單怎麼處理,選項有四個:直接建單、業務確認、信用審核、退回補資料。下面是資深同事口述的判斷原則。請整理成一張規則表:條件、對應的選項、例外情況;說得不清楚或互相衝突的地方,另外列出來問我。用表格輸出,讓我貼進 Excel 的「規則」工作表。
用上個月的訂單試判一次
附件是上個月 50 筆訂單(單號、客戶代號、品項、數量、金額,已拿掉當時的判斷),以及剛才的規則表。請依規則替每筆訂單從四個選項中選一個,標出「有把握」或「沒把握」,沒把握的寫出原因。用表格輸出:單號、選項、有沒有把握、原因。
把 AI 的答案和當時的判斷放在一起比對:答錯的,常常是規則還沒寫到的情況,補進規則表。它自己標的「有把握」不一定可信(下文會說明原因),要看那幾筆是不是真的比較常對。上傳前,用公司的企業方案,或先把客戶名稱換成代號、刪掉用不到的欄位。
現在就能做的 4 件事
不管之後用 Jev、LLM 還是單純的規則,這些準備都用得到。
1. 開始記錄每一次的判斷
在共用的 Excel 或 Google 試算表開一張表:日期、單號或訊息摘要、當時的判斷、最後的正確結果、經手人。「當時的判斷」用資料驗證做成下拉選單,選項和規則表一致。累積幾個月,就是驗證任何模型最重要的資料。
2. 標出每一種判斷出錯的影響
客服訊息分錯,多轉手一次就好;退款核准錯、付款條件放寬錯,就會直接造成損失。把每種判斷標上「影響小」或「影響大」,之後設門檻、決定哪些要一直保留人工覆核,就有依據。
3. 用簡單的規則先標出最明確的案子
有些案子很明確,例如老客戶、品項與價格都對得上的訂單。在 Excel 加一欄公式判斷是否符合規則,再用條件式格式設定把「需要人看」的單標上顏色。
4. 準備好評估 AI 服務時要問的問題
- 資料送到哪裡?會不會被保存或用於訓練?能不能自架?
- 中文資料的表現有沒有評測?能不能先用我們的歷史資料測試?
- 答案有沒有信心值?信心值有沒有校準?
Jev 是什麼?一個「不說話」的 AI 模型
Jev 是 TypeSafe AI 的第一個模型。這家公司位於舊金山、2024 年成立,執行長 Diogo Almeida 曾在 OpenAI 參與 RLHF、InstructGPT 與 ChatGPT 的研究。公司在 9 月 15 日結束隱身期,同時宣布由創投 DCVC 領投的 4,000 萬美元種子輪,Jev 也以有限的早期存取(early access)方式推出(SiliconANGLE)。
TypeSafe 把這類模型稱為 System One 模型(見官方發表文):名稱來自心理學家康納曼所說的「系統一」—— 快速、直覺的判斷,相對於慢慢推理的「系統二」。Jev 這個名字則取自經濟學家 Jevons,也就是「成本下降、用量反而大增」的傑文斯悖論。
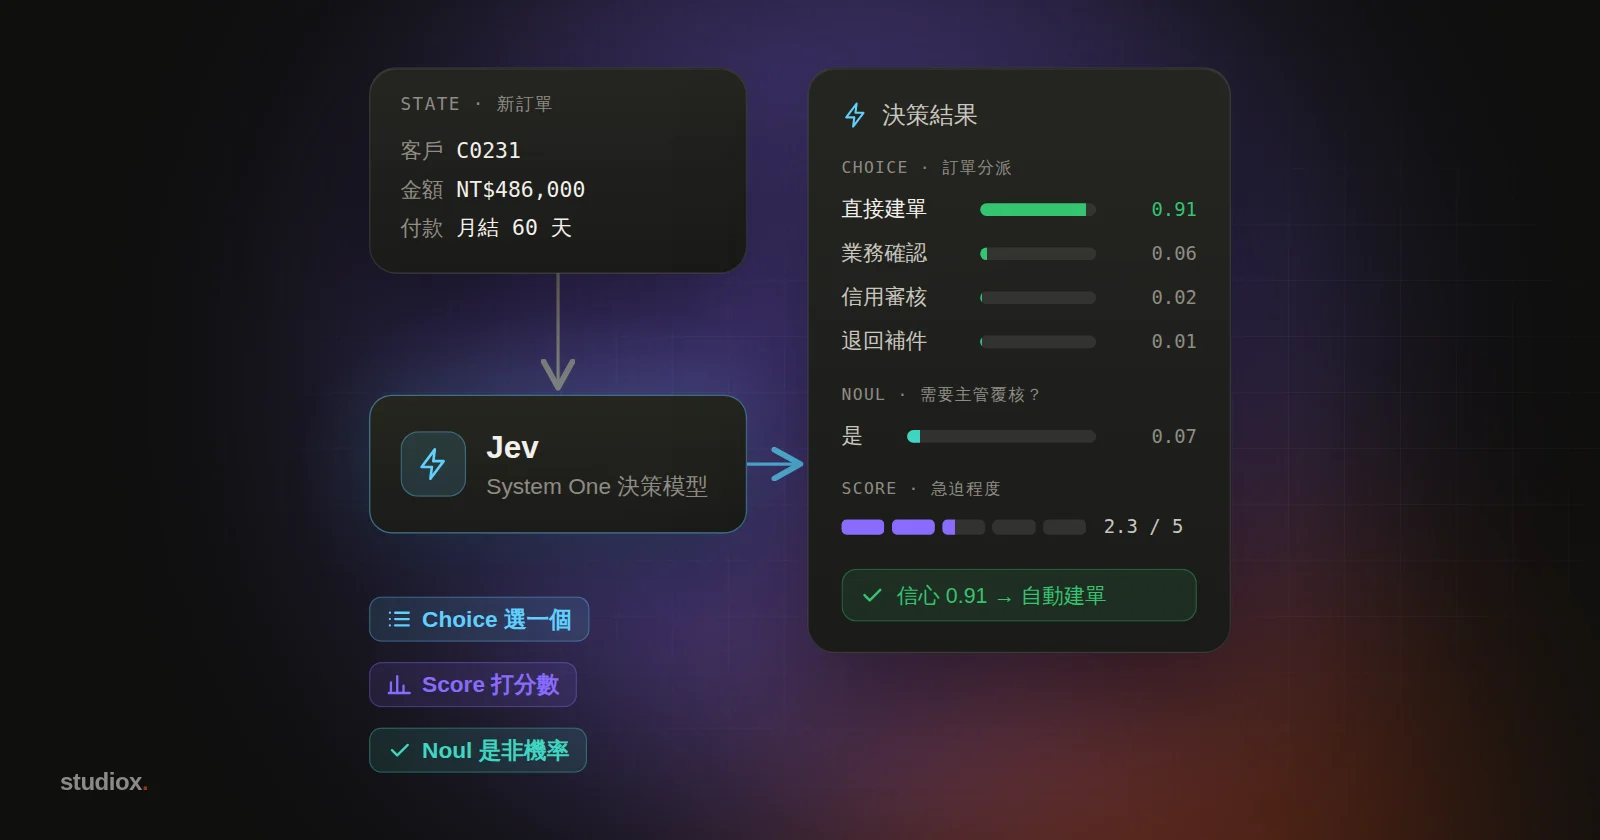
使用方式很單純:交給它一份「狀態」(一則客戶訊息、一筆訂單的 JSON 資料),再附上幾個事先定義好的問題。它會在一次呼叫裡同時回答所有問題,每個答案都是程式能直接使用的型別,而且只會從你給的選項裡選。問題有三種:
| 題型 | 回傳什麼 | 例子 |
|---|---|---|
| Choice(選擇) | 從你列出的選項中挑一個,附上每個選項的機率與信心值 | 這張訂單該走:直接建單/業務確認/信用審核/退回補資料 |
| Score(評分) | 在你用文字描述的等級上打分數,附上各等級的機率與信心值 | 這則客訴的急迫程度,1 到 5 級 |
| Noul(是非) | 一個 0 到 1 之間、答案為「是」的機率 | 這筆退貨符合退貨條件嗎? |
和用 LLM 做同一個判斷,差在哪?
LLM 是一個字一個字產生文字的模型。拿它來做判斷,通常要請它「只回答 A、B、C 或 D」,再寫程式解析;它說「我很確定」,也不代表真的比較可能對。Jev 則把結果直接放進你定義好的格式裡,不會回出清單以外的答案。
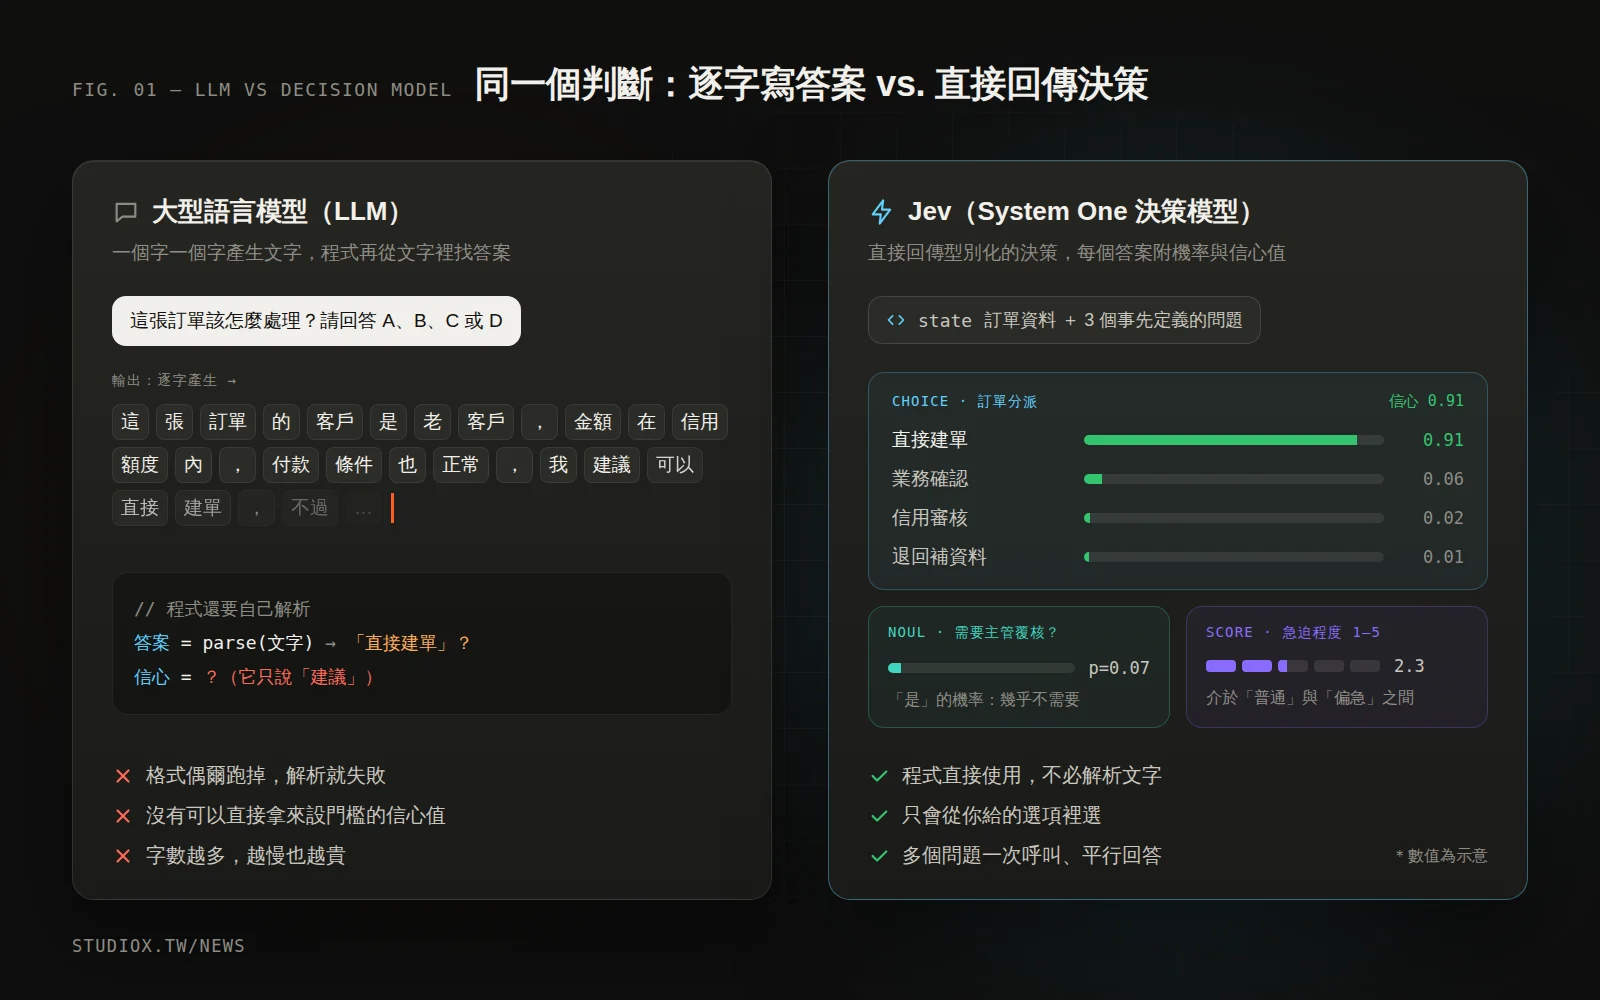
| 用 LLM 做判斷 | 用 Jev 做判斷 | |
|---|---|---|
| 輸出 | 一段文字,要再解析 | 選項、分數或是非機率 |
| 信心 | 通常沒有,或是它自己「說」的 | 每個答案附機率與信心值 |
| 多個問題 | 常要分次問或寫長提示 | 一次呼叫、平行回答 |
| 速度與成本 | 隨輸出字數增加 | 原廠宣稱快很多、便宜很多(見下文) |
速度與成本方面,TypeSafe 宣稱在它挑選的判斷類工作上,Jev 比前沿 LLM 快、便宜約兩個數量級;在它自建的四個工作流程測試中,最高約 193 倍快、445 倍便宜(Tom's Hardware)。請注意,這些都是原廠自己的數字:TypeSafe 在發表文中也承認,測試流程由自家團隊設計、可能有偏差,數字大概落在實際效益的高端。Forbes 的報導則提到,早期測試顯示速度與成本優勢明顯,但準確度略低於最大型的模型。
LLM 仍然不可少的地方
Jev 不寫回信、不做摘要,也不做開放式的多步驟推理;它不直接看 PDF 或照片。這些仍然是 LLM 與 AI Agent 的工作。比較實際的組合是:
- LLM 讀懂:從客戶的訂單 PDF 或訊息中擷取欄位(見用 AI 讀訂單與報價單)。
- Jev 決定:這張單走哪條路、要不要人看。
- 系統執行:寫入 ERP、通知業務,或放進人工確認清單。
信心值怎麼用:設一條門檻,決定哪些交給人
仔細看日常流程,大部分步驟其實是決策,而不是寫作:這張訂單進哪個佇列?這筆退貨准不准?這則訊息該給誰?這筆交易需不需要主管看?
這類決策要自動化,難的不是「給出答案」,而是知道哪些答案可以放心交給系統。這就是校準(calibration)的意義:一個校準良好的模型說「0.8」時,在大量類似的判斷中,大約八成是對的。TypeSafe 說它用一種叫 RLCD(Reinforcement Learning for Calibrated Decisions)的訓練方法,目標就是讓機率「說實話」;不過在 Latent Space 的訪談中也提到,這個方法的細節尚未公開發表。
有了可信的信心值,就能設一條門檻:高於門檻的自動處理,低於門檻的轉給人。MarkTechPost 的程式教學示範的「依信心分流」就是這個模式。門檻設多少,就看前面第 2 步標的出錯影響:影響小的(例如分類客服訊息)門檻可以低一點;影響大的(例如核准退款、放寬付款條件)門檻要高,甚至一直保留人工覆核。
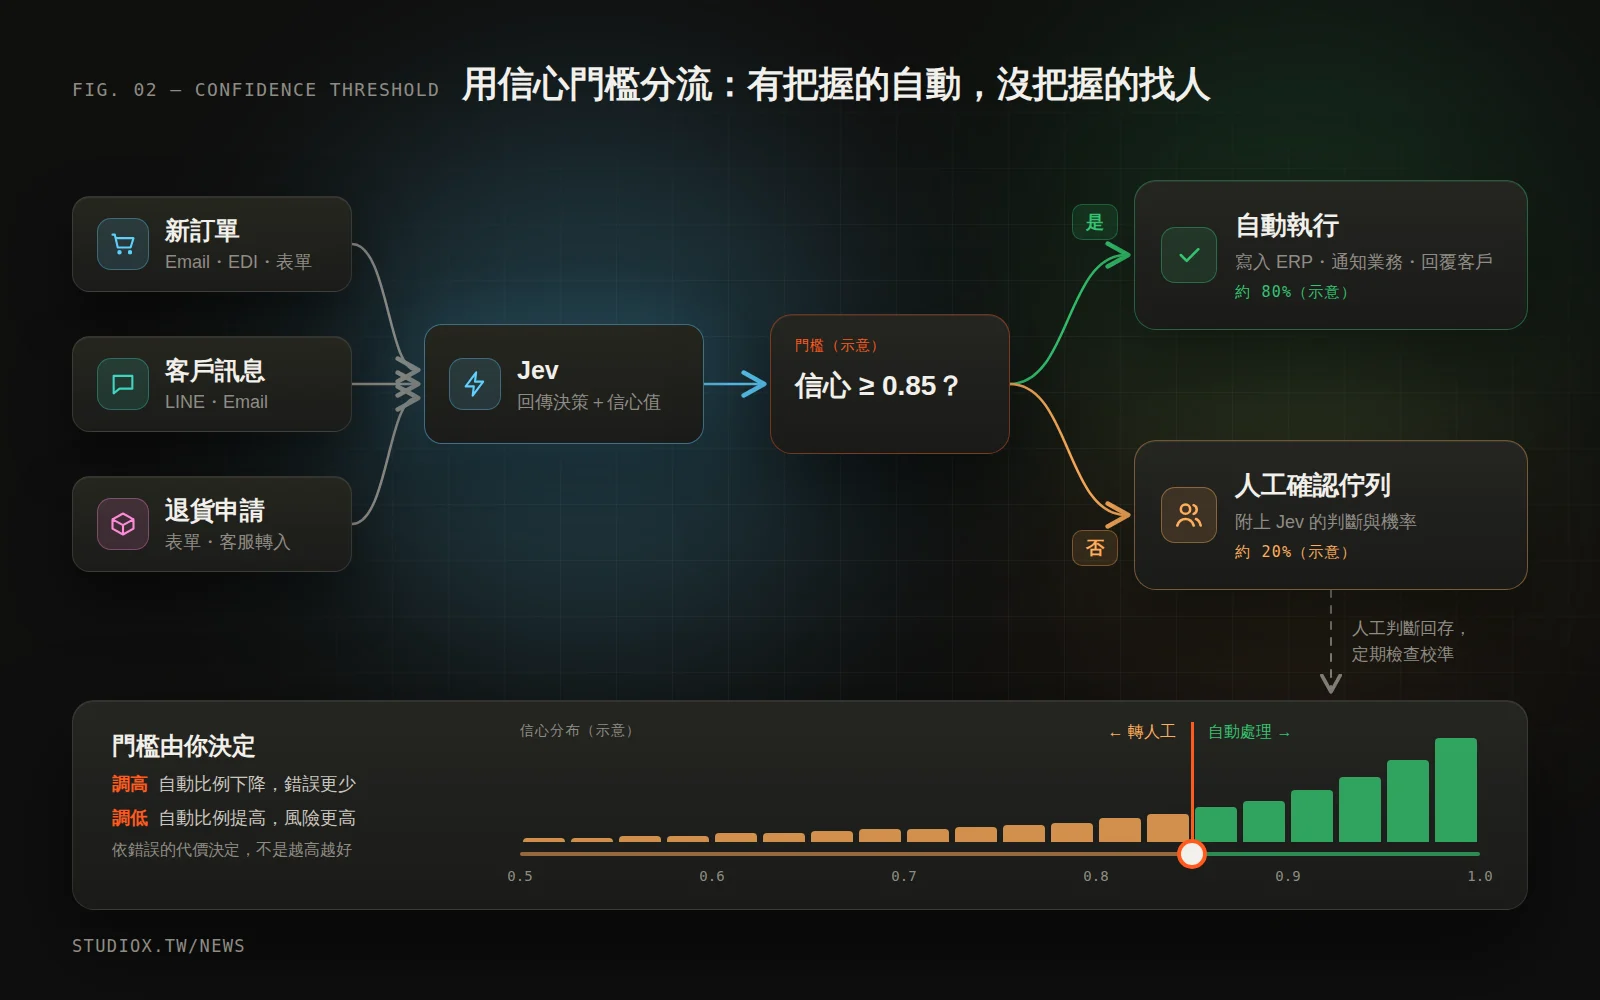
量大時,速度與成本也很重要。TypeSafe 公布的回應時間是每次 70 到 500 毫秒;上市時的價格是每百萬輸入 token 0.042 美元、輸出不另計費(原廠數字,早期存取期間可能調整)。
傳統產業可以怎麼用?(示意情境)
以下是我們整理的示意情境,不是實際客戶案例:
| 流程 | 要做的決策 | 題型 | 有把握時 | 沒把握時 |
|---|---|---|---|---|
| 訂單分派 | 直接建單/業務確認/信用審核/退回補資料 | Choice | 自動寫入 ERP | 業助確認 |
| 客戶訊息分流 | 詢價、催貨、客訴或其他;是否需要主管 | Choice+是非 | 分給對應窗口 | 客服主管分派 |
| 退貨/理賠審核 | 是否符合退貨條件 | 是非 | 小額退貨自動核准 | 專人審核 |
| 品檢放行 | 依量測數據與檢驗紀錄判定是否放行 | 是非 | 放行 | 品管複檢 |
| 信用與付款條件 | 客戶風險等級 1 到 5 | Score | 套用標準條件 | 財務主管決定 |
共同點是:選項事先說得出來、量大、錯了有機會補救,和我們建議挑選第一個 AI 流程的標準一致。品檢如果要看影像,則要先由影像模型把結果轉成數據,Jev 再做判定。
現況與注意事項(撰寫於 2026 年 9 月底)
- 仍在早期存取,開放方式還在變:Jev 上市時採候補名單,約一週後一度開放所有人註冊,隨即又因需求太大暫停新註冊。申請方式請以官方最新公告為準。
- 新公司、新模型:撰寫本文時,Jev 上市不到兩週,效能數字主要來自原廠,獨立驗證還不多。
- 「不會亂回答」要正確理解:它不會回出選項以外的答案,但仍可能選錯,信心也可能偏高;Forbes 也提醒,它一樣要防範提示注入 —— 客戶寄來的內容,可能夾帶想操弄判斷的文字。
- 資料會送到雲端:Jev 目前透過 TypeSafe 的雲端 API 使用,沒有可以自架的版本。處理個資或機密資料前,要先確認合約與資料處理條款。
- 保留替換空間:把「輸入 → 選項+信心值」做成流程中的一個獨立節點,日後要換成其他模型或規則,不必重寫整個流程。
什麼時候可以考慮下一步
遇到下面這些情況,就可以考慮讓決策模型接手一部分:
- 同一類判斷一天要做幾百次,花的時間越來越長。
- 判斷紀錄已經累積了幾個月,選項和規則也穩定了。
- 希望明確的案子自動處理,業助專心處理例外。
下一步:用自己的歷史決策驗證,再分階段上線
「有校準」不能只聽原廠說,要用你自己的資料測,前面累積的判斷紀錄正好派上用場:
- 整理歷史決策:從紀錄表挑出已經有結果的案例,包含當時的輸入與正確答案。
- 看準確度,也看校準:把 Jev 的答案依信心分組,看每一組實際答對的比例。如果「信心 0.9 以上」那組只對了七成,代表它在你的業務上並沒有校準好。
- 影子模式:上線初期讓 Jev 在旁邊判斷、不執行,人照常作業,每週比對兩邊的差異。
- 設門檻:依出錯的影響,選一個「自動處理比例」和「漏網錯誤」都能接受的門檻。
- 持續監控:追蹤自動比例與被人工推翻的次數,定期抽查;換了新產品線或新客群,就重新驗證。
驗證結果可以整理成這樣的表(數字為示意):
| 信心區間 | 筆數 | 實際答對 | 判讀 |
|---|---|---|---|
| 0.95 以上 | 620 | 97% | 可以自動處理 |
| 0.85–0.95 | 210 | 90% | 依出錯的影響決定 |
| 0.85 以下 | 170 | 68% | 交給人 |
另外,中文資料一定要自己測:撰寫本文時,我們沒有找到原廠公布的中文評測數據。
StudioX 官網首頁的訂單自動化流程示意裡,負責分派的節點就是 Jev:AI 先讀懂訂單,Jev 判斷該走哪一條路,沒把握時才轉人工確認。但我們不會建議你因為一則新聞就改流程:先做影子測試、讓數字說話,再決定用 Jev、LLM 還是單純的規則;上線初期人工作業照舊並行。
如果你有一個每天要重複判斷幾百次的流程,可以先做一次免費的 AI 健檢,看看適不適合交給決策模型;也可以參考 AI 導入與整合服務,以及把判斷結果接回 ERP、LINE 客服的系統整合服務,或直接和我們聊聊。