敏感資料能用 AI 嗎?小模型與地端 AI 怎麼選
可以。一般工作用雲端 AI 的企業方案,最機密的資料交給能裝在公司伺服器上的小型語言模型。本文附 2 句不用貼機密資料的問法,幫你把資料分級、準備測試題,再看小模型適合哪些任務,以及混合架構怎麼讓敏感資料留在公司。
重點摘要
- 可以先直接問 AI:只給常用資料的名稱(不含內容),請 ChatGPT、Claude 或 Gemini 分成機密、內部、可公開三級,再從可公開與去識別化的資料試起。
- 小型語言模型(SLM)可以在自己的伺服器甚至筆電上執行,擅長分類、擷取欄位、摘要、依範本改寫這類範圍明確的任務。
- 雲端與地端的成本結構不同:雲端按用量付費,地端是一次性硬體加上維運人力;用自己的測試題實測再決定。
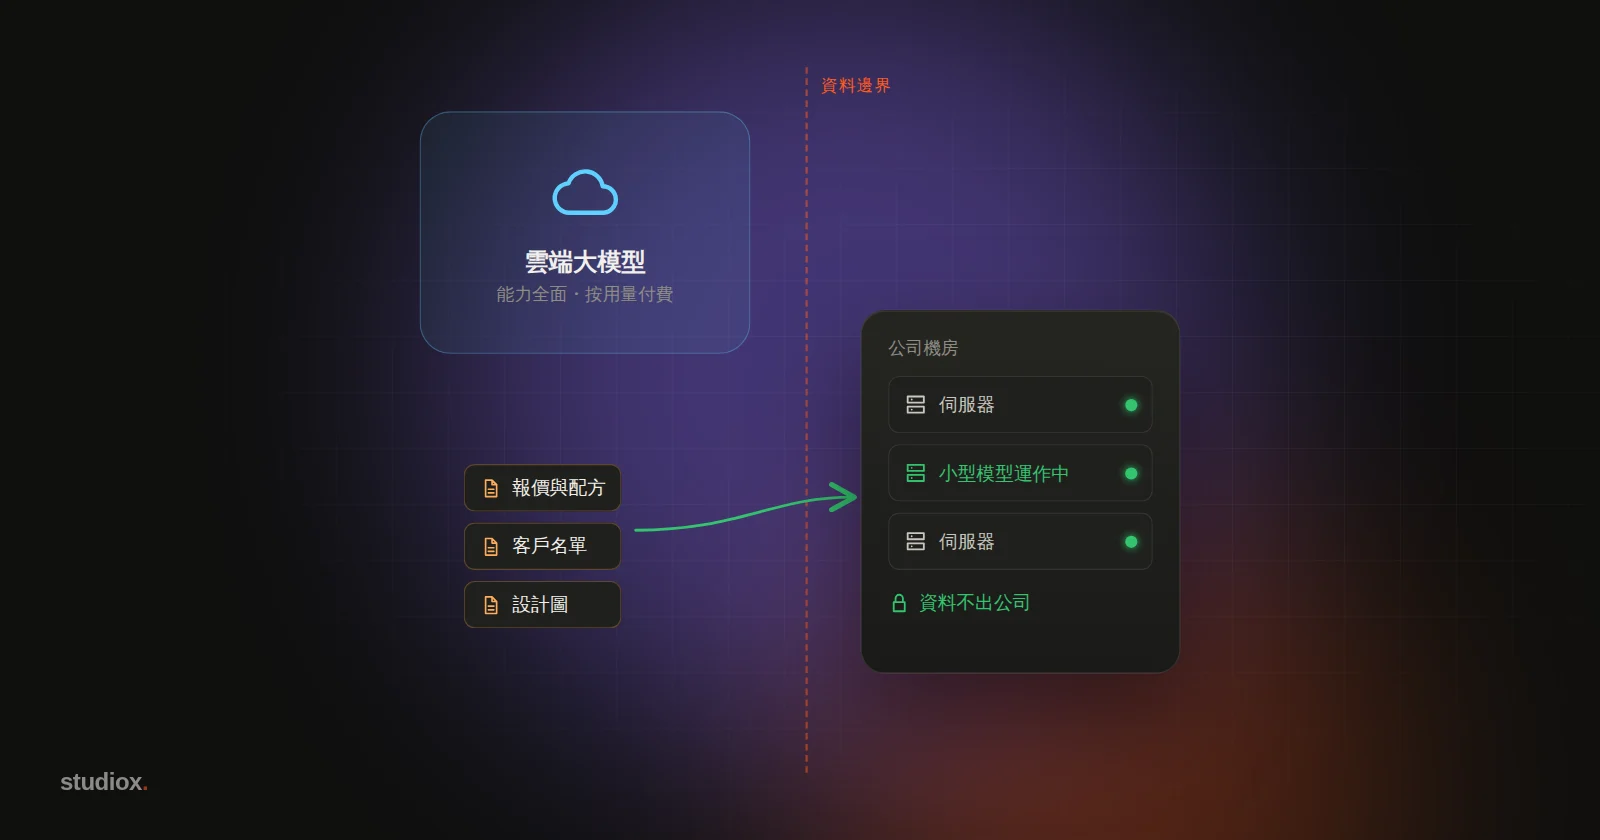
- 多數企業最適合混合架構:敏感資料在地端處理,一般任務用雲端大模型,由整合層分流並記錄每一次處理。
可以。一般工作用雲端 AI 的企業方案就好,主要服務多半提供資料不用於訓練、加密傳輸等保障;最不能外流的部分,交給裝在公司伺服器上的小型語言模型(Small Language Models,SLM),資料不必離開公司。
「我們的資料很敏感,不能傳到外面去。」這是很多企業評估 AI 時最先提出的考量,也很合理:報價、配方、客戶名單、設計圖、病歷、財務資料,本來就該謹慎處理。下面先給兩句不用貼機密資料的問法。
先直接問 AI
貼給 ChatGPT、Claude 或 Gemini 這類 AI 助理,把範例換成你的就好(範例都是示意)。
把資料分成三級
我們是金屬零件工廠。下面是常用的資料類型(只有名稱,沒有內容):報價單、成本表、客戶名單、設計圖、製程參數、員工薪資、產品型錄、官網文案。請把每一種分成「機密」「內部」「可公開」三級,各寫一句理由(例如涉及個資法、客戶保密協議或公司政策),並建議哪些可以用雲端 AI、哪些要先去識別化、哪些要留在公司內部。請用表格列出,讓我貼進 Excel。
準備一組測試題
我想測試 AI 能不能分類客服信件(詢價、客訴、出貨查詢、其他)。下面是 20 封已經去識別化的範例(客戶名稱換成代號,電話和地址已刪除)。請逐封分類並寫一句理由,再整理成測試表,欄位是:範例編號、內容摘要、AI 的分類、正確答案(留空,我來填)、是否正確。
AI 分的級只是草稿,受法規或客戶合約限制的資料要由你對照確認;正確答案請熟悉業務的同事填。確認公司用的是企業方案之前,報價、配方、客戶名單的內容先不要貼給雲端 AI。
現在就能做的 5 件事
1. 把資料分成三級
把第一句問法得到的表格貼進 Excel,請負責的同事逐項確認,並註明依據:法規、客戶合約還是公司政策。
2. 從可公開與去識別化的資料開始用
產品介紹、公開規格、已經上架的文案,很適合先交給 AI 改寫與整理。內部資料先去識別化再用:姓名換成「客戶 A」,電話與地址刪掉;在 Excel 裡可以用「尋找與取代」一次換掉同一個名字。
3. 確認雲端方案提供哪些保障
先確認同事用的是個人版還是企業方案,再向服務商問清楚四件事:資料會不會用於訓練、保存多久、存放在哪個區域、能不能要求刪除。
4. 準備一組自己的測試題
挑一個想交給 AI 的任務,準備 50–100 個真實案例和正確答案(要到雲端測的先去識別化,可用第二句問法整理)。之後不管測雲端還是地端模型,都用這組題目比較準確度(錯在哪裡)、速度(在預計的硬體上、多人同時使用時)、穩定性(結果與格式是否一致)和中文能力(繁體中文與台灣用語,不同模型差異很大)。網路上的評比分數可以參考,但自己的資料最準。
5. 想好誰負責維運
地端 AI 需要有人部署、監控、處理故障與更新,可以是內部同事或合作夥伴。還沒有人選之前,先用雲端企業方案,同時累積測試結果。
什麼是小型語言模型?
一般提到的大型語言模型,多由 AI 公司在雲端提供,參數規模龐大、能力全面。小型語言模型的參數少得多,特色是:
- 可以在自己的環境執行:公司的伺服器、工作站,甚至筆電。
- 速度快、成本可預測:不用按每次呼叫付費。
- 可以針對特定任務調整:用公司的資料微調,熟悉特定領域的用語。
常見的開放權重模型家族有 Llama、Qwen、Gemma、Mistral 等,大小各不相同。每個模型的授權條款不同,商業使用前一定要確認。
雲端大模型與地端小模型怎麼比?
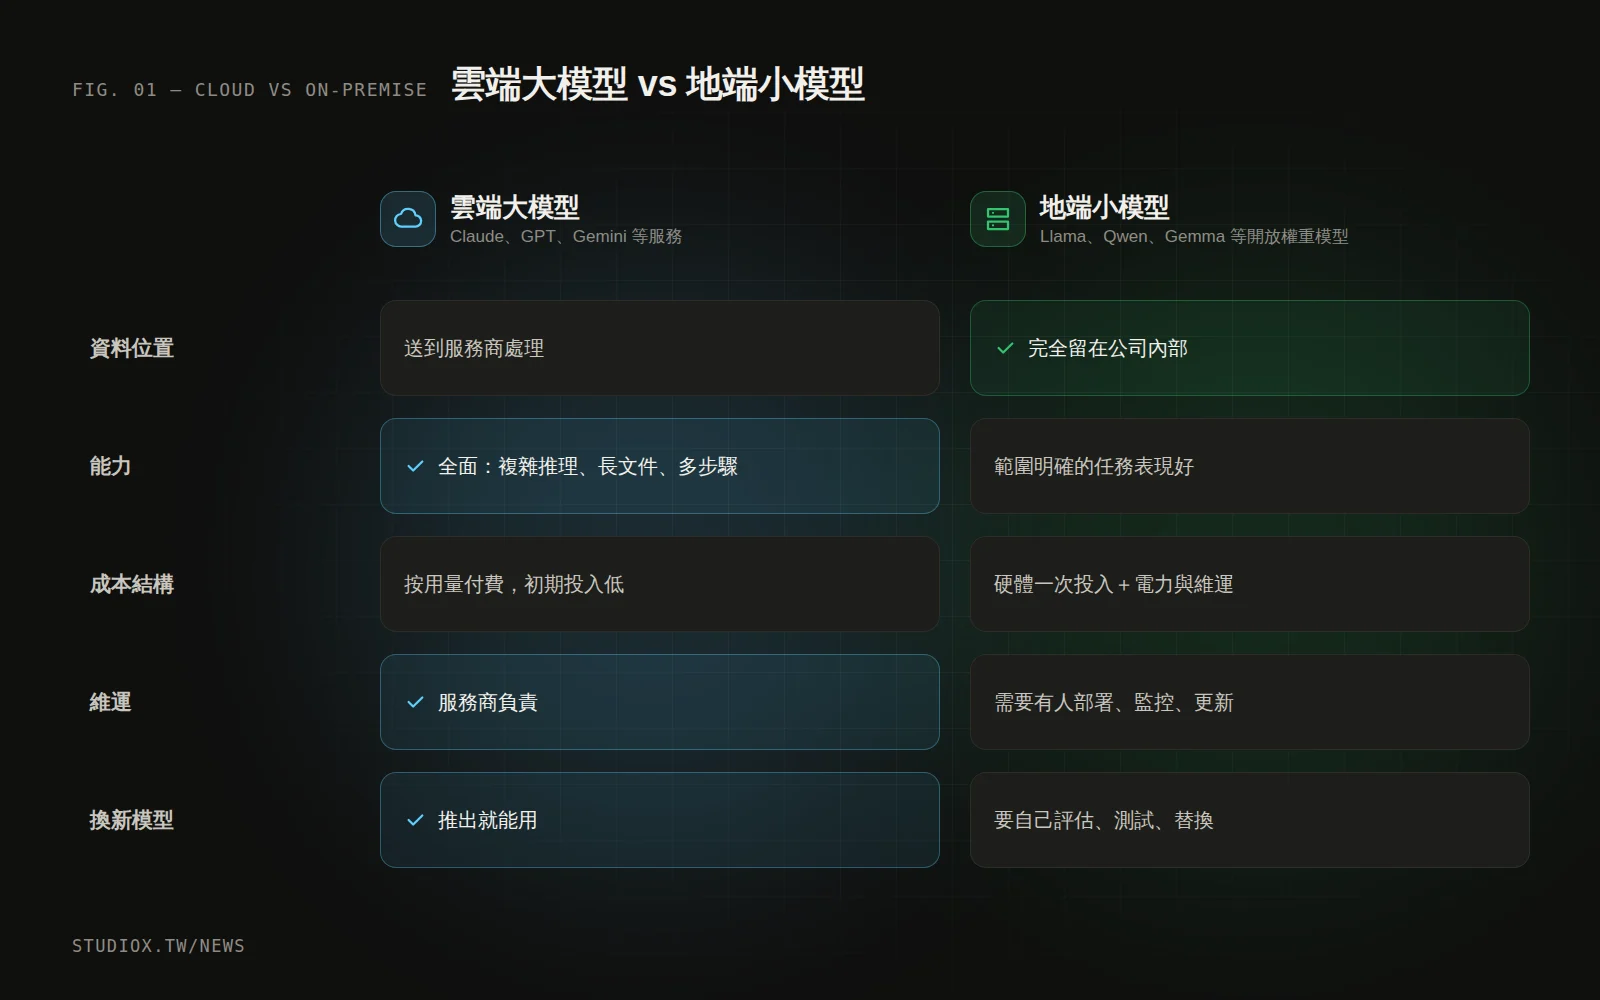
| 比較 | 雲端大模型 | 地端小模型 |
|---|---|---|
| 資料位置 | 傳送到服務商處理(企業方案多有不訓練、加密等保障) | 完全留在公司內部 |
| 能力 | 全面,擅長複雜推理、長文件、多步驟任務 | 範圍明確的任務表現好,複雜推理較弱 |
| 成本結構 | 按用量付費,初期投入低 | 硬體一次性投入,加上電力與維運 |
| 維運 | 服務商負責 | 需要有人負責部署、監控、更新 |
| 更新速度 | 新模型推出就能使用 | 要自己評估、測試、替換 |
小模型適合做什麼?
小模型在範圍明確、有標準答案的任務上表現很好:
- 分類與分流:這封信是詢價、客訴還是垃圾信?
- 欄位擷取:從文件裡找出客戶名稱、品號、數量、日期(見用 AI 讀訂單與報價單)。
- 摘要:把會議紀錄、客服對話整理成重點。
- 依範本改寫:把技術規格改寫成給客戶看的說明。
- 敏感資料的前處理:先在地端把個資遮蔽,再把處理過的內容交給雲端大模型。
需要廣泛知識、多步驟規劃、長時間自主工作的任務(例如 AI Agent 跨系統處理複雜流程),目前還是雲端大模型比較可靠。
怎麼判斷該用哪一種?
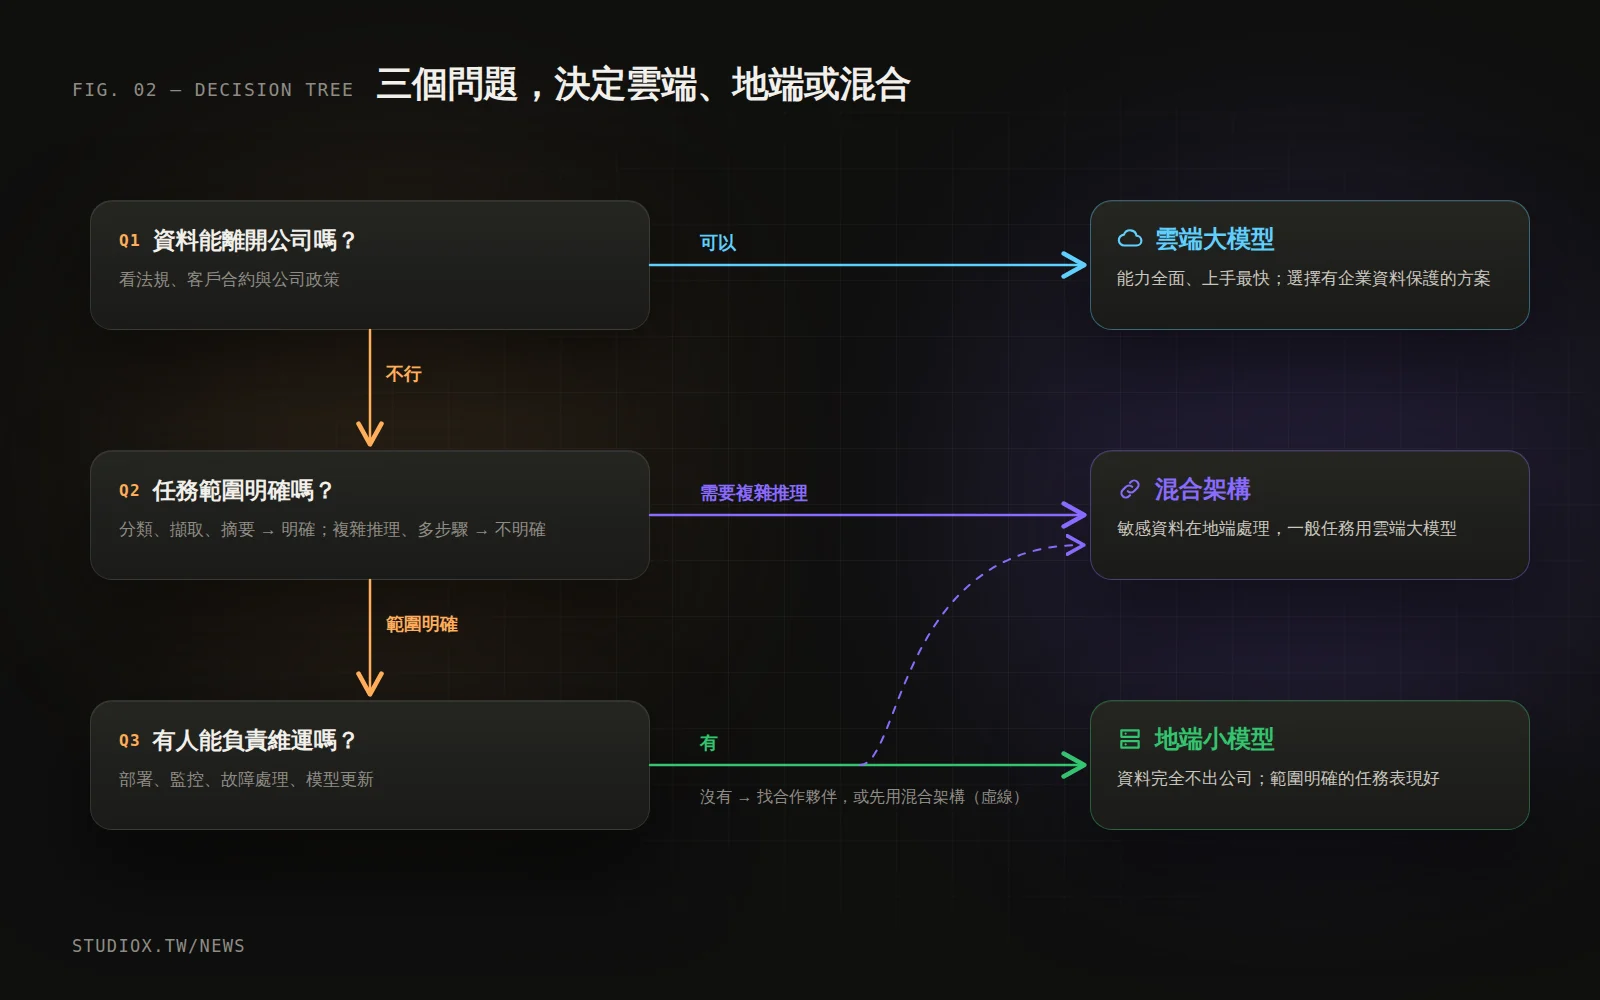
用前面的準備,回答三個問題:
- 資料是否受法規、客戶合約或公司政策限制,不能離開公司?(第 1 步)是的話,這部分要在地端處理。
- 任務是否範圍明確、有標準答案?(第 4 步)是的話,小模型通常就夠用;需要複雜推理的,考慮雲端大模型或混合架構。
- 有沒有人能負責維運?(第 5 步)還沒有的話,找合作夥伴,或先從雲端開始。
什麼時候可以考慮下一步
做好上面的準備,很多工作用雲端企業方案就能安心處理。遇到這些情況,可以考慮把一部分 AI 放進公司:
- 想交給 AI 的工作裡,「機密」資料越來越多。
- 想分析客服紀錄這類含個資的資料,去識別化越來越花時間。
- 測試題的結果顯示,小模型在你的任務上已經夠用。
下一步:混合架構,讓敏感資料留在公司
實務上,多數企業最適合的是混合架構:敏感資料在地端處理,一般任務(撰寫文案、分析公開或已去識別化的資料)用雲端大模型,再由一個整合層依資料類型與任務分流到對的模型,並記錄每一次處理。這樣不必一開始就投入大量硬體。
以分析過去一年的客服對話為例(示意),對話裡有姓名、電話、地址與訂單內容:
- 地端小模型先處理:在公司內部的伺服器上遮蔽個資(姓名換成「客戶 A」、電話與地址移除),並把對話分類(出貨、品質、退款、其他)。
- 只把去識別化的內容交給雲端:遮蔽過的摘要送到雲端大模型,歸納根本原因、提出改善建議。
- 結果回到公司內部:報告存在公司的系統裡,並記錄每次用了哪個模型、處理了哪些資料。
設計的重點,是在資料離開公司之前,先決定哪些資訊可以被帶走。
導入時,先用第 4 步的測試題比較雲端與地端,再決定分工;成本要把電力、機房空間、人力與更新算進去(算法見本地 AI 的理由與成本);試點期間照原本的方式工作,AI 的結果先由人確認,架構上也要能輕鬆替換模型。
資料不能出公司,不代表不能用 AI。想知道你的資料與任務適合哪一種方式,可以先做一次免費的 AI 健檢,或參考我們的 AI 導入與整合服務與企業系統開發,也歡迎直接和我們聊聊你的需求。